
Cách chuẩn bị dữ liệu triển khai hệ thống công nghệ mới
Mục lục
- Xác định phạm vi dữ liệu và tiêu chí đạt trước khi bắt đầu làm sạch
- Kiểm kê và profiling để biết dữ liệu đang có vấn đề ở đâu
- Làm sạch dữ liệu theo nguyên nhân thay vì chỉ sửa biểu hiện
- Chuẩn hóa cấu trúc, định dạng và mã dùng chung theo hệ thống đích
- Mapping dữ liệu và chạy migration thử trước khi chuyển dữ liệu thật
- Kiểm tra chất lượng và đối soát trước khi go-live
Chuẩn bị dữ liệu triển khai hệ thống không chỉ là xóa dữ liệu sai. Doanh nghiệp cần xác định dữ liệu nào được chuyển, làm sạch và chuẩn hóa theo quy tắc thống nhất, mapping đúng cấu trúc hệ thống mới, chạy migration thử và kiểm tra chất lượng bằng tiêu chí có thể đo lường trước khi go-live.
Dữ liệu nên được chuẩn bị như một hạng mục triển khai độc lập, bắt đầu từ việc xác định phạm vi và tiêu chuẩn chất lượng thay vì chuyển toàn bộ dữ liệu cũ sang hệ thống mới rồi mới xử lý lỗi. Trình tự hợp lý là xác định dữ liệu cần dùng → kiểm kê và profiling → làm sạch → chuẩn hóa → mapping và chuyển đổi → migration thử → đối soát và nghiệm thu.
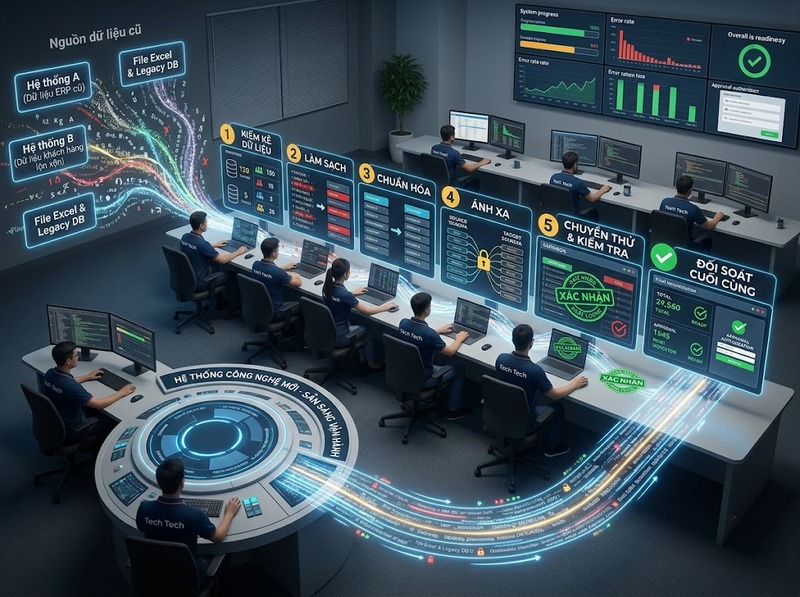
Điểm quan trọng là “dữ liệu sạch” không đồng nghĩa với “dữ liệu sẵn sàng cho hệ thống mới”. Một tập dữ liệu có thể không chứa lỗi chính tả nhưng vẫn không sử dụng được nếu thiếu khóa liên kết, sai định dạng, khác quy ước mã hóa, không xác định được bản ghi gốc hoặc không đáp ứng rule của hệ thống đích. Vì vậy, chuẩn bị dữ liệu phải đồng thời xử lý chất lượng, cấu trúc, quan hệ và khả năng sử dụng sau migration.
ISO/IEC 25012:2008 định nghĩa một mô hình chất lượng dữ liệu tổng quát cho dữ liệu có cấu trúc trong hệ thống máy tính và cho phép sử dụng mô hình này để xác định yêu cầu, thước đo cũng như thực hiện đánh giá chất lượng dữ liệu. Tiêu chuẩn này được ISO rà soát và xác nhận lại vào năm 2025, do đó vẫn là phiên bản hiện hành.
Xác định phạm vi dữ liệu và tiêu chí đạt trước khi bắt đầu làm sạch
Bước đầu tiên không phải sửa dữ liệu mà là xác định dữ liệu nào thực sự cần được đưa sang hệ thống mới. Nếu phạm vi chưa rõ, nhóm triển khai rất dễ dành thời gian làm sạch những bảng, trường hoặc lịch sử giao dịch mà hệ thống mới không sử dụng.
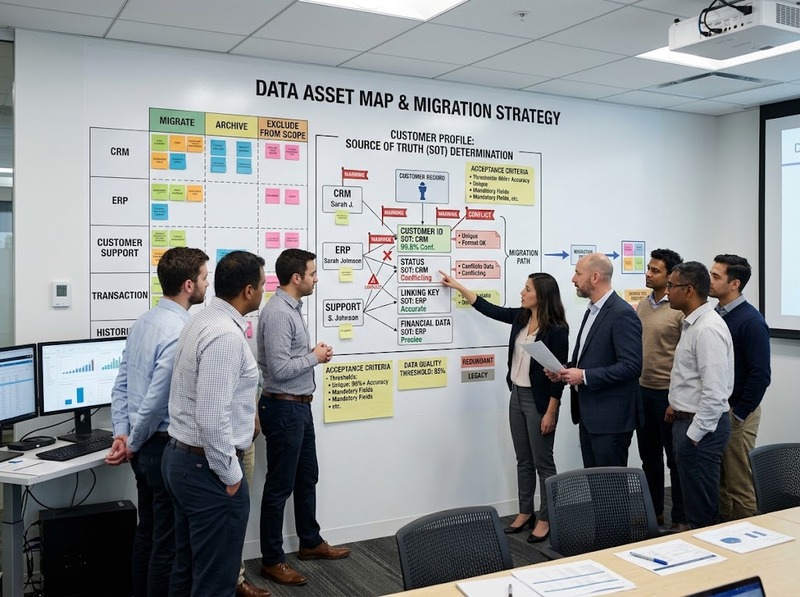
Nên phân loại dữ liệu nguồn thành các nhóm như dữ liệu chủ, dữ liệu giao dịch, dữ liệu tham chiếu, dữ liệu cấu hình và dữ liệu lịch sử. Với từng nhóm cần trả lời bốn câu hỏi: hệ thống mới có cần dữ liệu này không, cần bao nhiêu năm lịch sử, trường nào bắt buộc và ai có quyền xác nhận dữ liệu đúng.
Cùng lúc đó, doanh nghiệp cần xác định source of truth cho những đối tượng xuất hiện ở nhiều hệ thống. Chẳng hạn, thông tin khách hàng có thể nằm trong CRM, ERP và phần mềm chăm sóc khách hàng. Nếu ba nguồn ghi địa chỉ hoặc trạng thái khách hàng khác nhau nhưng không chỉ định nguồn ưu tiên, bước làm sạch sau đó chỉ tạo ra một tập dữ liệu “đồng nhất về hình thức” chứ chưa chắc đúng về nghiệp vụ.
Tiêu chí chất lượng cũng phải được định nghĩa trước migration. Sáu chiều chất lượng thường được sử dụng gồm accuracy, completeness, consistency, timeliness, uniqueness và validity. IBM mô tả các chiều này như những đặc tính có thể đo lường để so sánh trạng thái thực tế của dữ liệu với trạng thái mà tổ chức yêu cầu.
Không có một tỷ lệ đạt chung phù hợp cho mọi dự án. Ngưỡng phải xuất phát từ mức độ quan trọng của từng trường và nghiệp vụ. Ví dụ, dự án có thể yêu cầu:
· 100% trường bắt buộc của bản ghi được migrate phải có giá trị hợp lệ
· 100% khóa ngoại quan trọng phải tham chiếu tới bản ghi tồn tại
· Không còn bản ghi trùng theo bộ quy tắc nhận diện đã phê duyệt
· 100% mã trạng thái phải thuộc danh mục mà hệ thống mới chấp nhận
· Tổng số bản ghi hoặc tổng giá trị tài chính sau migration phải đối soát với nguồn theo quy tắc đã thống nhất
Đây là acceptance criteria của dự án, không phải benchmark áp dụng cho mọi doanh nghiệp. Những trường ít quan trọng có thể chấp nhận một tỷ lệ thiếu nhất định, trong khi mã khách hàng, khóa giao dịch hay dữ liệu phục vụ kế toán thường cần kiểm soát nghiêm ngặt hơn.
Kiểm kê và profiling để biết dữ liệu đang có vấn đề ở đâu
Sau khi khóa phạm vi, cần lập data inventory và thực hiện profiling trước khi chỉnh sửa. Profiling trả lời câu hỏi “dữ liệu hiện đang như thế nào?”, nhờ đó nhóm dự án biết phải sửa vấn đề nào và mức độ nghiêm trọng ra sao.
Với mỗi bảng hoặc đối tượng, nên thu thập tối thiểu số lượng bản ghi, kiểu dữ liệu, tỷ lệ NULL, số giá trị duy nhất, tần suất giá trị, giá trị nhỏ nhất/lớn nhất, mẫu định dạng, tỷ lệ trùng và các quan hệ khóa. Với trường ngày tháng, cần tìm những ngày không hợp lệ hoặc nằm ngoài logic nghiệp vụ. Với email, số điện thoại hay mã định danh, cần kiểm tra pattern và độ dài. Với các bảng liên kết, phải tìm orphan record — bản ghi con đang tham chiếu đến một bản ghi cha không tồn tại.
Profiling đặc biệt quan trọng vì lỗi dữ liệu thường không xuất hiện đơn lẻ. Ví dụ, một trường “Mã tỉnh” có thể chứa đồng thời HN, Hà Nội, 01, Ha Noi và giá trị trống. Nếu chỉ sửa từng bản ghi sai mà chưa xác định quy tắc chuẩn, dữ liệu sẽ tiếp tục không nhất quán.
Kết quả profiling nên chuyển thành data issue log thay vì chỉ là báo cáo thống kê. Mỗi nhóm lỗi cần có mức độ ưu tiên, số bản ghi bị ảnh hưởng, rule xử lý, người chịu trách nhiệm nghiệp vụ và cách xác nhận sau sửa.
Cách này giúp phân biệt hai loại vấn đề thường bị trộn lẫn: lỗi có thể xử lý tự động và lỗi cần quyết định nghiệp vụ. Xóa khoảng trắng thừa có thể tự động hóa; nhưng lựa chọn địa chỉ nào là địa chỉ chính khi một khách hàng có ba địa chỉ khác nhau thường cần business owner quyết định.
Làm sạch dữ liệu theo nguyên nhân thay vì chỉ sửa biểu hiện
Làm sạch dữ liệu nhằm loại bỏ hoặc xử lý những bản ghi không đáp ứng yêu cầu sử dụng của hệ thống mới. Các vấn đề phổ biến gồm thiếu dữ liệu, dữ liệu trùng, giá trị không hợp lệ, lỗi nhập liệu, bản ghi không còn sử dụng và mâu thuẫn giữa nhiều nguồn.
Xử lý dữ liệu thiếu và không hợp lệ
Không nên mặc định điền giá trị cho mọi trường trống. Trước tiên cần xác định trường đó có thực sự bắt buộc hay không.
Nếu trường bắt buộc nhưng thiếu dữ liệu, có thể khôi phục từ một nguồn đáng tin cậy khác, yêu cầu bộ phận nghiệp vụ bổ sung hoặc loại bản ghi khỏi phạm vi migration khi dữ liệu không đủ điều kiện. Việc tự tạo giá trị mặc định chỉ để vượt validation của hệ thống đích có thể khiến lỗi kỹ thuật biến thành lỗi nghiệp vụ khó phát hiện hơn.
Validity cũng cần được kiểm tra theo rule, không chỉ theo kiểu dữ liệu. Một ngày sinh có thể đúng định dạng nhưng không hợp lệ nếu nằm trong tương lai. Mã sản phẩm có thể là chuỗi hợp lệ về mặt kỹ thuật nhưng vẫn sai nếu mã đó không tồn tại trong catalog được phê duyệt.
IBM phân biệt validity là mức độ dữ liệu tuân theo định dạng, kiểu hoặc miền giá trị đã định nghĩa; uniqueness đánh giá sự tồn tại của bản ghi trùng; completeness đánh giá dữ liệu bắt buộc có hiện diện hay không.
Xử lý dữ liệu trùng theo quy tắc nhận diện
Không nên loại trùng chỉ bằng cách so sánh một trường như tên khách hàng. Hai người có thể cùng tên, trong khi cùng một khách hàng lại có nhiều cách viết tên khác nhau.
Quy tắc deduplication nên sử dụng khóa định danh đáng tin cậy hoặc tổ hợp thuộc tính, chẳng hạn mã khách hàng, mã số thuế, số điện thoại và email. Sau khi xác định hai bản ghi thuộc cùng một thực thể, cần có survivorship rule để quyết định giá trị nào được giữ lại.
Ví dụ, số điện thoại có thể lấy từ nguồn được cập nhật gần nhất, mã số thuế lấy từ nguồn đã được xác minh, còn địa chỉ lấy từ hệ thống được chỉ định là master. Nếu chỉ merge dữ liệu mà không định nghĩa rule ưu tiên, cùng một loại lỗi sẽ xuất hiện trở lại ở lần chạy migration tiếp theo.
Chuẩn hóa cấu trúc, định dạng và mã dùng chung theo hệ thống đích
Làm sạch trả lời câu hỏi “giá trị này có đúng không?”, còn chuẩn hóa trả lời câu hỏi “giá trị đúng phải được biểu diễn theo cách nào để toàn hệ thống hiểu giống nhau?”.
Các điểm thường cần chuẩn hóa gồm ngày tháng, múi giờ, số điện thoại, địa chỉ, đơn vị đo, tiền tệ, chữ hoa/chữ thường, mã quốc gia, mã phòng ban, trạng thái nghiệp vụ và cách biểu diễn giá trị NULL.
Ví dụ, dữ liệu nguồn có thể sử dụng ba giá trị Active, A và 1 cho cùng trạng thái hoạt động, trong khi hệ thống mới chỉ chấp nhận ACTIVE. Việc chuẩn hóa cần đưa cả ba giá trị về một mã đích duy nhất và lưu mapping rõ ràng để có thể kiểm tra lại.
Với master data và reference data, cần đặc biệt thận trọng. Nếu hệ thống mới đã có danh mục quốc gia, đơn vị, loại khách hàng hoặc nhóm sản phẩm riêng, dữ liệu nguồn phải được ánh xạ vào danh mục đó thay vì tạo thêm biến thể mới.
Chuẩn hóa cũng phải tính đến quan hệ giữa các bảng. Việc đổi một mã khách hàng từ KH0001 thành C000001 không chỉ tác động tới bảng khách hàng mà còn tới mọi bảng đơn hàng, công nợ, hợp đồng hoặc lịch sử có tham chiếu đến mã đó. Vì vậy, transformation phải bảo toàn referential integrity, không chỉ thay đổi giá trị từng cột riêng lẻ.
Một hiểu nhầm thường gặp là chuẩn hóa càng mạnh thì dữ liệu càng tốt. Thực tế, không nên chuẩn hóa đến mức làm mất ý nghĩa gốc. Chẳng hạn, ép mọi tên người hoặc địa chỉ về một kiểu viết có thể làm mất dấu hoặc ký tự cần thiết. Nguyên tắc phù hợp là chuẩn hóa những thuộc tính mà hệ thống và nghiệp vụ yêu cầu thống nhất, đồng thời bảo toàn thông tin gốc khi cần truy vết.
Mapping dữ liệu và chạy migration thử trước khi chuyển dữ liệu thật
Khi dữ liệu đã được làm sạch và chuẩn hóa, cần xây dựng source-to-target mapping. Đây là tài liệu mô tả mỗi trường nguồn sẽ đi đâu trong hệ thống mới và phải biến đổi như thế nào.
Một mapping đầy đủ không chỉ ghi “cột A → cột B”. Nó cần thể hiện kiểu dữ liệu nguồn và đích, transformation rule, giá trị mặc định nếu được phép, reference mapping, điều kiện loại trừ và rule xử lý lỗi.
Có bốn trường hợp cần được nhận diện rõ:
1. Trường nguồn được chuyển trực tiếp sang trường đích
2. Trường nguồn phải chuyển đổi định dạng hoặc giá trị
3. Một trường đích được tạo từ nhiều trường nguồn
4. Dữ liệu nguồn không còn được sử dụng trong mô hình đích
Mapping phải được review bởi cả nhóm kỹ thuật và nghiệp vụ. Nhóm kỹ thuật có thể xác nhận transformation chạy đúng, nhưng business owner mới có thể xác nhận việc chuyển CustomerType = 02 thành Corporate có đúng ý nghĩa nghiệp vụ hay không.
Sau đó nên chạy migration trong môi trường thử nghiệm với chính pipeline dự kiến dùng khi go-live. Một migration thử có giá trị khi kiểm tra được toàn chuỗi extract → transform → load → validate, không chỉ thử import một file mẫu nhỏ.
Sau mỗi lần chạy, lỗi phải được phân loại. Nếu lỗi đến từ dữ liệu nguồn, cần bổ sung cleaning rule. Nếu do transformation, sửa mapping hoặc logic chuyển đổi. Nếu do constraint của hệ thống đích, cần xác nhận lại requirement. Quy trình lặp này nên tiếp tục cho đến khi dữ liệu đạt acceptance criteria đã định nghĩa ở đầu dự án.
Điểm cần tránh là sửa thủ công trực tiếp trên file migration cuối cùng mà không cập nhật rule. Cách làm đó có thể giúp một lần import thành công nhưng khiến kết quả không tái lập được khi phải chạy migration lần nữa.
Kiểm tra chất lượng và đối soát trước khi go-live
Migration thành công về mặt kỹ thuật chưa có nghĩa dữ liệu đã đúng. Một job ETL có thể chạy 100% không lỗi nhưng vẫn đưa sai trạng thái khách hàng, sai tỷ giá hoặc sai quan hệ giữa các thực thể nếu transformation rule ban đầu không chính xác.
Vì vậy, validation sau migration nên được thực hiện ở ba lớp.
Lớp thứ nhất là kiểm tra kỹ thuật. Kiểm tra số lượng bản ghi, trường bắt buộc, kiểu dữ liệu, uniqueness, constraint và referential integrity. Mục tiêu là xác nhận dữ liệu đáp ứng cấu trúc hệ thống đích.
Lớp thứ hai là reconciliation. So sánh dữ liệu nguồn và đích theo các chỉ số có ý nghĩa. Không chỉ đối chiếu số dòng mà còn có thể kiểm tra tổng giá trị đơn hàng, tổng số dư, số khách hàng theo trạng thái hoặc số giao dịch theo kỳ. Hai hệ thống có cùng số bản ghi vẫn có thể sai nếu các giá trị bên trong đã bị biến đổi không đúng.
Lớp thứ ba là business validation. Người dùng nghiệp vụ kiểm tra một tập dữ liệu đại diện và những trường hợp rủi ro cao để xác nhận dữ liệu sau chuyển đổi vẫn mang đúng ý nghĩa. Đây là bước bắt lỗi mà kiểm thử kỹ thuật khó phát hiện, chẳng hạn hợp đồng đã hết hạn nhưng lại được chuyển thành trạng thái đang hoạt động.
Các tiêu chí kiểm tra nên gắn trực tiếp với những chiều chất lượng đã xác định từ đầu. IBM lưu ý rằng data quality rules có thể được dùng để đánh giá dữ liệu theo completeness, consistency, uniqueness, validity và các chiều chất lượng khác; chất lượng cần được so sánh với yêu cầu của use case chứ không phải một khái niệm “sạch” chung chung.
Go-live chỉ nên được phê duyệt khi các lỗi còn tồn tại đã được phân loại và chấp nhận rõ ràng. Một lỗi nhỏ ở trường ghi chú có thể không chặn triển khai, nhưng một lỗi liên quan khóa định danh, số dư tài chính hoặc quan hệ giữa các thực thể có thể cần được xử lý trước khi chuyển hệ thống.
Sau khi nghiệm thu, cần lưu lại mapping, cleaning rules, báo cáo đối soát, danh sách exception và phiên bản dữ liệu đã sử dụng. Đây là cơ sở để truy vết nếu người dùng phát hiện sai lệch sau go-live.
Chuẩn bị dữ liệu triển khai hệ thống hiệu quả vì thế không phải một bước “dọn dữ liệu” ở cuối dự án mà là một quy trình kiểm soát xuyên suốt. Doanh nghiệp cần xác định trước dữ liệu nào được chuyển và tiêu chuẩn nào được coi là đạt; sau đó profiling để hiểu hiện trạng, làm sạch các lỗi có căn cứ, chuẩn hóa theo mô hình đích, thực hiện mapping có thể truy vết và chạy migration thử. Chỉ khi dữ liệu sau chuyển đổi vượt qua cả kiểm tra kỹ thuật, đối soát và xác nhận nghiệp vụ thì mới có cơ sở để coi dữ liệu sẵn sàng cho hệ thống công nghệ mới.

GỬI Ý KIẾN BÌNH LUẬN
