
Cách xử lý dữ liệu nghiên cứu thị trường trước phân tích
Mục lục
- Bắt đầu bằng kiểm tra cấu trúc và định nghĩa quy tắc chất lượng
- Phát hiện bản ghi lỗi, trùng lặp và phản hồi không đáng tin cậy
- Xử lý dữ liệu thiếu và giá trị ngoại lệ mà không làm sai phân bố
- Chuẩn hóa, mã hóa và biến đổi dữ liệu thành dạng có thể phân tích
- Kiểm tra logic và tính nhất quán giữa các biến
- Kiểm tra chất lượng cuối cùng và khóa bộ dữ liệu trước phân tích
Dữ liệu nghiên cứu thị trường cần được kiểm tra, làm sạch, chuẩn hóa, mã hóa và xác nhận chất lượng trước khi phân tích. Một quy trình tốt không chỉ loại lỗi mà còn bảo toàn thông tin hợp lệ, ghi lại mọi thay đổi và tạo ra bộ dữ liệu có thể phân tích, kiểm tra và tái lập.
Dữ liệu thị trường hiếm khi đi thẳng từ bước thu thập sang phân tích. Bản ghi có thể bị thiếu, trùng, sai kiểu dữ liệu, mâu thuẫn logic, chứa phản hồi chất lượng thấp hoặc sử dụng những cách mã hóa khác nhau cho cùng một khái niệm. Vì vậy, xử lý dữ liệu nghiên cứu thị trường thực chất gồm hai nhiệm vụ liên tiếp: làm sạch để phát hiện và xử lý vấn đề chất lượng, sau đó chuẩn bị để dữ liệu có cấu trúc, định nghĩa và định dạng phù hợp với phân tích.
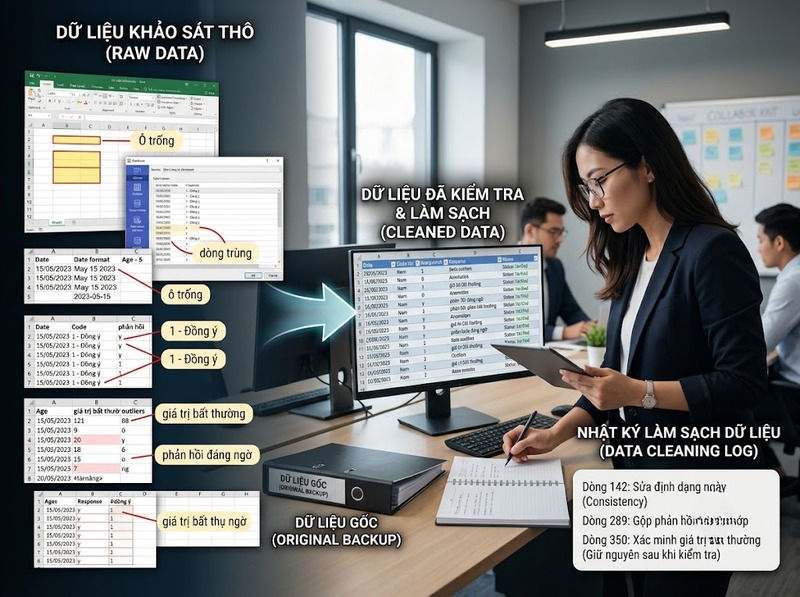
Điểm quan trọng là không nên hiểu “làm sạch” đồng nghĩa với xóa mọi giá trị bất thường. Một giá trị cực đoan có thể là lỗi nhập liệu, nhưng cũng có thể phản ánh một khách hàng thực sự có mức chi tiêu rất cao. Tương tự, thời gian hoàn thành khảo sát ngắn có thể là tín hiệu phản hồi kém chất lượng nhưng chưa đủ để tự động loại người trả lời. Quy trình tốt vì thế phải dựa trên rule được xác định trước, kết hợp nhiều dấu hiệu và giữ được dấu vết của mọi quyết định chỉnh sửa.
Bắt đầu bằng kiểm tra cấu trúc và định nghĩa quy tắc chất lượng
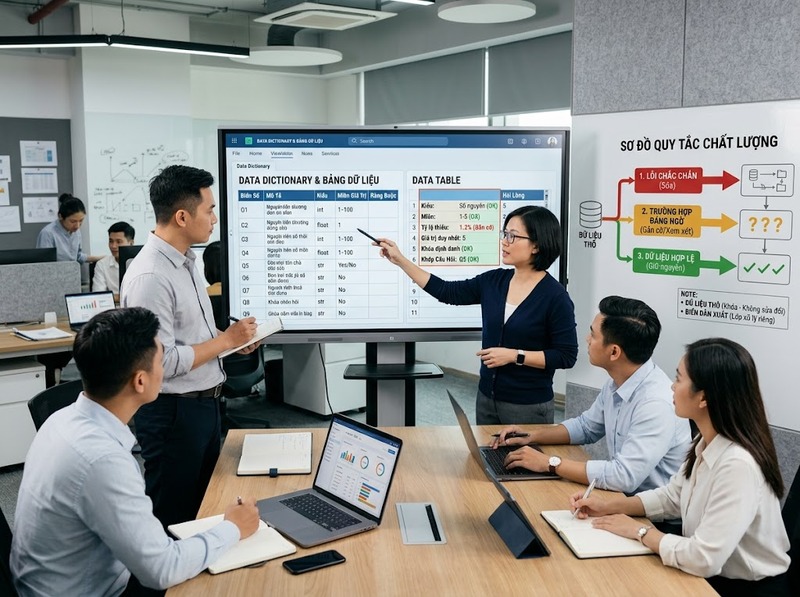
Trước khi sửa từng ô dữ liệu, cần kiểm tra bộ dữ liệu ở cấp cấu trúc. Mục tiêu là xác định dữ liệu đang có những biến nào, mỗi biến đại diện cho điều gì, kiểu dữ liệu dự kiến là gì và giá trị nào được xem là hợp lệ.
Ví dụ, biến tuổi có thể phải là số nguyên không âm; câu hỏi mức độ hài lòng có thể chỉ nhận giá trị từ 1 đến 5; biến ngày phỏng vấn phải có định dạng ngày; còn câu hỏi lựa chọn thương hiệu cần sử dụng cùng một hệ mã trong toàn bộ dataset. Nếu không khóa các định nghĩa này trước, một thay đổi được xem là “làm sạch” ở bước sau có thể vô tình làm sai ý nghĩa của dữ liệu.
Một data audit ban đầu thường kiểm tra số bản ghi, số biến, kiểu dữ liệu, miền giá trị, tỷ lệ thiếu, giá trị duy nhất, khóa định danh và sự phù hợp giữa dataset với bảng hỏi hoặc data dictionary. Đây cũng là thời điểm xác định biến gốc và biến dẫn xuất để tránh ghi đè dữ liệu thô.
Trong thực hành nghiên cứu chuyên nghiệp, tư duy kiểm soát chất lượng của các khung như ISO 20252 đặt trọng tâm vào quy trình được xác định, tài liệu hóa và có khả năng truy vết. Điều này quan trọng hơn việc áp một ngưỡng làm sạch duy nhất cho mọi dự án, bởi thiết kế mẫu, bảng hỏi, phương thức thu thập và loại dữ liệu có thể rất khác nhau.
Kết quả của bước này nên là một tập rule rõ ràng: điều kiện nào được xem là lỗi chắc chắn, điều kiện nào chỉ tạo cờ cảnh báo, trường hợp nào được sửa tự động và trường hợp nào phải được xem xét trước khi loại bỏ.
Phát hiện bản ghi lỗi, trùng lặp và phản hồi không đáng tin cậy
Sau khi cấu trúc đã được xác nhận, bước tiếp theo là kiểm tra chất lượng ở cấp bản ghi. Với dữ liệu khảo sát, một record có thể hoàn chỉnh về mặt kỹ thuật nhưng vẫn không đủ đáng tin cậy để đưa vào phân tích.
Các dấu hiệu thường được xem xét gồm bản ghi trùng, thời gian trả lời bất thường, trả lời một mẫu duy nhất trên ma trận câu hỏi, mâu thuẫn giữa các câu liên quan, nội dung câu trả lời mở vô nghĩa hoặc nhiều tín hiệu cho thấy người tham gia không đọc câu hỏi.
Tuy nhiên, mỗi tín hiệu nên được xem như một flag, không mặc định là lý do xóa. Chẳng hạn, một quy tắc vận hành có thể đánh dấu những cuộc khảo sát hoàn thành trong thời gian dưới khoảng một phần ba thời gian trung vị của mẫu để kiểm tra hiện tượng speeding. Đây là ngưỡng sàng lọc minh họa, không phải tiêu chuẩn ngành áp dụng cho mọi bảng hỏi. Khảo sát ngắn, người trả lời quen chủ đề hoặc thiết bị khác nhau đều có thể làm thời gian hoàn thành giảm đáng kể.
Straight-lining cũng cần được diễn giải thận trọng. Việc chọn cùng một mức cho toàn bộ ma trận dài có thể phản ánh thiếu chú ý, nhưng nếu các phát biểu cùng đo một thái độ tương tự thì câu trả lời đồng nhất vẫn có thể hợp lệ. Quyết định loại bản ghi đáng tin cậy hơn khi nhiều chỉ báo cùng xuất hiện, chẳng hạn thời gian quá ngắn kết hợp với straight-lining và thất bại ở câu kiểm tra chú ý.
Đối với bản ghi trùng, khóa định danh trực tiếp thường mạnh hơn các tín hiệu như cùng địa chỉ IP. Nhiều người hợp lệ có thể dùng chung mạng doanh nghiệp hoặc hộ gia đình. Vì vậy, cần kết hợp respondent ID, thời điểm gửi, thiết bị, thông tin hồ sơ và mẫu câu trả lời trước khi xác định một record thực sự là duplicate.
Nguyên tắc chung là lỗi chắc chắn có thể được sửa hoặc loại theo rule; tín hiệu nghi ngờ cần được xác minh bằng nhiều bằng chứng hơn.
Xử lý dữ liệu thiếu và giá trị ngoại lệ mà không làm sai phân bố
Missing value và outlier là hai nhóm dễ bị xử lý quá mức nhất. Nếu mọi ô trống đều được điền và mọi giá trị cực đoan đều bị xóa, dataset có thể trông “sạch” hơn nhưng lại phản ánh thị trường kém chính xác hơn.
Trước hết cần phân biệt nguyên nhân thiếu dữ liệu. Một câu hỏi bị bỏ qua do logic skip khác hoàn toàn với câu hỏi đáng lẽ phải trả lời nhưng không có dữ liệu. Trường hợp thứ nhất là thiếu theo thiết kế và thường không phải lỗi. Trường hợp thứ hai cần được đánh dấu để đánh giá ảnh hưởng tới biến và phân tích dự kiến.
Không có một tỷ lệ missing duy nhất quyết định dữ liệu có thể sử dụng hay không. Ý nghĩa của tỷ lệ thiếu phụ thuộc vào tầm quan trọng của biến, cách phát sinh missing và phương pháp phân tích sau đó. Một biến phân khúc cốt lõi bị thiếu ở một nhóm người trả lời có hệ thống có thể đáng lo hơn một biến phụ có tỷ lệ thiếu cao hơn nhưng phân bố ngẫu nhiên.
Việc điền giá trị thiếu cũng không nên thực hiện chỉ để dataset không còn ô trống. Thay thế missing bằng trung bình có thể làm giảm phương sai và thay đổi quan hệ giữa các biến. Nếu cần imputation, phương pháp phải phù hợp với bản chất dữ liệu và được ghi rõ trong hồ sơ xử lý.
Với outlier, các quy tắc thống kê như giá trị nằm ngoài khoảng Q1 - 1,5 × IQR đến Q3 1,5 × IQR có thể được dùng để phát hiện điểm cần xem xét, chứ không tự động chứng minh đó là dữ liệu sai. Trong nghiên cứu mức chi tiêu, doanh thu hoặc tần suất mua, đuôi phân bố dài có thể chính là đặc điểm thật của thị trường.
Cách xử lý nên dựa vào nguyên nhân. Nếu giá trị 500 tuổi xuất hiện ở biến tuổi, có cơ sở mạnh để xem đây là lỗi. Nhưng khoản chi tiêu gấp nhiều lần trung vị vẫn có thể thuộc về một khách hàng giá trị cao. Khi không thể xác minh, các lựa chọn như giữ nguyên, winsorize, chuyển thành missing hoặc loại record cần được quyết định theo mục đích phân tích và ghi lại đầy đủ.
Chuẩn hóa, mã hóa và biến đổi dữ liệu thành dạng có thể phân tích
Sau khi các lỗi chất lượng chính đã được xử lý, dataset cần được chuẩn hóa để cùng một khái niệm luôn được biểu diễn theo cùng một cách.
Một vấn đề phổ biến là dữ liệu tương đương nhưng được lưu dưới nhiều dạng khác nhau: “Hà Nội”, “Ha Noi” và “HN”; giới tính được mã hóa lúc bằng chữ, lúc bằng số; giá tiền sử dụng nhiều đơn vị; ngày tháng có định dạng khác nhau. Nếu không chuẩn hóa, phần mềm phân tích có thể coi chúng là các nhóm riêng biệt.
Các biến phân loại cần có codebook xác định rõ mã và nhãn. Ví dụ, nếu 1 = Có và 0 = Không, quy tắc này phải nhất quán trong dataset và tài liệu đi kèm. Không nên để một file sử dụng 1/2, file khác sử dụng Y/N rồi ghép trực tiếp.
Câu hỏi chọn nhiều phương án thường cần chuyển thành các biến nhị phân riêng để phân tích. Câu trả lời mở có thể cần coding thành nhóm chủ đề, nhưng phải giữ lại văn bản gốc để có thể kiểm tra quyết định mã hóa. Khi việc coding có yếu tố phán đoán, tiêu chí phân loại phải đủ rõ để những người mã hóa khác nhau hiểu cùng một cách.
Các biến dẫn xuất như nhóm tuổi, mức chi tiêu theo khoảng, điểm tổng hợp hay nhóm khách hàng cũng nên được tạo từ biến gốc thay vì thay thế chúng. Cách làm này giữ khả năng quay lại kiểm tra nếu logic phân nhóm thay đổi.
Chuẩn hóa còn bao gồm đơn vị đo, số chữ số thập phân, timezone, định dạng ngày, quy ước missing và tên biến. Giá trị của bước này không chỉ nằm ở sự gọn gàng: nó ngăn cùng một khái niệm bị phân tích thành nhiều định nghĩa khác nhau.
Kiểm tra logic và tính nhất quán giữa các biến
Một dataset có thể không chứa giá trị vượt miền cho phép nhưng vẫn sai về mặt logic. Vì vậy, kiểm tra từng biến riêng lẻ phải được tiếp nối bằng kiểm tra quan hệ giữa các biến.
Ví dụ, người trả lời cho biết “chưa từng mua sản phẩm” nhưng lại có dữ liệu về “số lần mua trong tháng trước”; người dưới độ tuổi yêu cầu lại được ghi nhận ở một nhóm chỉ dành cho người trưởng thành; hoặc câu hỏi chỉ được hiển thị cho khách hàng hiện tại nhưng xuất hiện dữ liệu ở nhóm không đủ điều kiện.
Các trường hợp như vậy thường xuất phát từ lỗi routing, ghép dữ liệu, nhập liệu hoặc cập nhật biến không đồng bộ. Chỉ kiểm tra range sẽ không phát hiện được chúng.
Logic check nên được xây dựng trực tiếp từ cấu trúc bảng hỏi và định nghĩa nghiệp vụ. Có thể biểu diễn dưới dạng điều kiện: nếu biến A nhận giá trị X thì biến B phải thuộc một tập giá trị nhất định, phải trống theo thiết kế hoặc phải có dữ liệu. Khi điều kiện bị vi phạm, record được gắn cờ để xác định nguyên nhân trước khi chỉnh sửa.
Đối với dữ liệu ghép từ nhiều nguồn, cần kiểm tra thêm tính toàn vẹn của khóa nối. Sau mỗi phép join, nên đối soát số dòng trước và sau, số khóa không khớp, khóa xuất hiện nhiều lần và hiện tượng một bản ghi bị nhân lên ngoài dự kiến. Một phép ghép sai có thể tạo ra sai số lớn hơn nhiều so với vài giá trị thiếu đơn lẻ vì nó làm thay đổi trực tiếp số quan sát và trọng số ngầm của dữ liệu.
Kiểm tra logic vì thế là lớp bảo vệ giữa “dữ liệu có vẻ hợp lệ” và “dữ liệu thực sự nhất quán với thiết kế nghiên cứu”.
Kiểm tra chất lượng cuối cùng và khóa bộ dữ liệu trước phân tích
Sau các bước làm sạch và chuẩn hóa, cần thực hiện một vòng QA cuối thay vì chuyển ngay sang phân tích. Mục tiêu là xác nhận rằng quá trình xử lý không tạo ra lỗi mới và dataset cuối vẫn có thể đối chiếu với dữ liệu ban đầu.
Một bảng kiểm QA hữu ích có thể bao gồm:
|
Hạng mục kiểm tra |
Chỉ số cần đối soát |
Cách diễn giải |
|
Số bản ghi |
Raw, bị loại, còn lại |
Tổng phải đối chiếu được với log xử lý |
|
Bản ghi trùng |
Số duplicate được phát hiện và xử lý |
Phải có lý do loại hoặc giữ |
|
Missing |
Tỷ lệ thiếu theo từng biến quan trọng |
So sánh trước và sau xử lý |
|
Range |
Giá trị ngoài miền hợp lệ |
Sau QA không còn lỗi chưa được giải thích |
|
Outlier |
Số điểm bị flag theo rule |
Flag không đồng nghĩa với tự động loại |
|
Logic |
Số vi phạm điều kiện chéo |
Mỗi trường hợp phải có trạng thái xử lý |
|
Mã hóa |
Mã không có trong codebook |
Dataset cuối phải thống nhất với định nghĩa biến |
|
Ghép dữ liệu |
Khóa unmatched và khóa nhiều-một bất thường |
Phải giải thích được thay đổi số dòng |
Một nguyên tắc quan trọng là luôn giữ raw data bất biến. Các thao tác làm sạch nên được thực hiện trên bản sao hoặc thông qua script có thể chạy lại. Cleaning log cần ghi rule nào đã được áp dụng, bản ghi hoặc biến nào bị ảnh hưởng, giá trị trước và sau thay đổi và lý do xử lý.
Khi một nhóm record bị loại, nên đối chiếu đặc điểm của nhóm bị loại với nhóm được giữ lại. Nếu tỷ lệ loại tập trung bất thường ở một khu vực, thiết bị, nhóm tuổi hoặc nguồn mẫu, quá trình cleaning có thể đang tạo ra selection bias thay vì chỉ loại dữ liệu kém chất lượng.
Dataset chỉ nên được “khóa” cho phân tích khi số quan sát đã đối soát được, các biến quan trọng đạt rule chất lượng, logic chéo đã được kiểm tra, coding nhất quán và mọi thay đổi đều có khả năng truy vết. Khi đó, nhà phân tích có thể biết rõ mình đang phân tích phiên bản dữ liệu nào và vì sao phiên bản đó khác dữ liệu thô.
Xử lý dữ liệu nghiên cứu thị trường trước phân tích không phải là thao tác xóa lỗi đơn thuần. Quy trình đầy đủ bắt đầu từ việc xác định tiêu chí chất lượng, phát hiện bản ghi không hợp lệ, xử lý missing và outlier, chuẩn hóa cách biểu diễn, kiểm tra logic giữa các biến rồi thực hiện QA cuối cùng.
Chất lượng của dataset không được đo bằng việc nó “sạch” đến mức nào, mà bằng việc các quyết định xử lý có hợp lý, nhất quán và truy vết được hay không. Giữ nguyên dữ liệu thô, sử dụng rule rõ ràng và khóa một phiên bản dữ liệu đã qua QA giúp giảm nguy cơ biến lỗi tiền xử lý thành kết luận sai ở giai đoạn phân tích.

GỬI Ý KIẾN BÌNH LUẬN
