
Cách đánh giá hiệu năng hệ thống trước khi lựa chọn
Mục lục
- Xác định tiêu chí hiệu năng trước khi chạy benchmark
- Đo tốc độ và độ trễ theo phân bố thay vì chỉ nhìn trung bình
- Đánh giá thông lượng cùng với tải đồng thời
- Theo dõi tài nguyên để tìm điểm nghẽn và phần dung lượng dự phòng
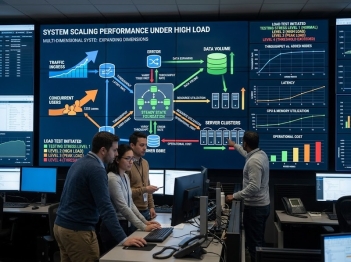
- Kiểm tra hiệu năng khi tải tăng, tăng đột biến và kéo dài
- Đánh giá khả năng mở rộng qua đường cong tải và hiệu năng
- So sánh các phương án bằng cùng một ma trận hiệu năng
Đánh giá hiệu năng hệ thống cần dựa trên tải thực tế, độ trễ, thông lượng, tỷ lệ lỗi, mức sử dụng tài nguyên và khả năng duy trì mục tiêu hiệu năng khi tải tăng, thay vì chỉ nhìn vào một thông số tốc độ đơn lẻ.
Một hệ thống chỉ thực sự có hiệu năng phù hợp khi đáp ứng được khối lượng công việc dự kiến trong giới hạn thời gian, tỷ lệ lỗi và tài nguyên chấp nhận được. Vì vậy, kết quả benchmark ở trạng thái tải thấp hoặc một con số tốc độ tối đa chưa đủ để quyết định lựa chọn.
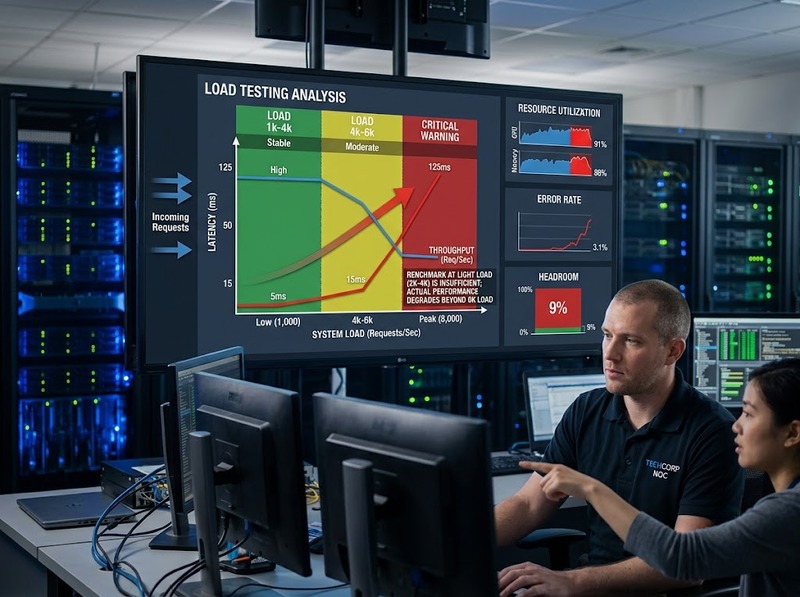
Cách đánh giá đáng tin cậy hơn là đặt hệ thống vào cùng một workload, theo dõi tốc độ xử lý, độ trễ, thông lượng, lỗi và mức tiêu thụ tài nguyên đồng thời. Sau đó tiếp tục tăng tải để xác định điểm hiệu năng bắt đầu suy giảm, khả năng mở rộng và phần dung lượng dự phòng. Giá trị của mỗi chỉ số chỉ có ý nghĩa khi được đối chiếu với yêu cầu vận hành cụ thể của hệ thống.
Xác định tiêu chí hiệu năng trước khi chạy benchmark
Đánh giá nên bắt đầu bằng yêu cầu đo được, không bắt đầu bằng cấu hình phần cứng hoặc kết quả quảng cáo của nhà cung cấp. Nếu chưa biết hệ thống phải phục vụ bao nhiêu yêu cầu, cần phản hồi nhanh đến mức nào và tỷ lệ thất bại tối đa có thể chấp nhận là bao nhiêu, một kết quả benchmark cao vẫn chưa cho biết hệ thống có phù hợp hay không.
Một bộ yêu cầu hiệu năng thường cần làm rõ ít nhất bốn yếu tố: workload, độ trễ mục tiêu, thông lượng cần xử lý và tỷ lệ lỗi cho phép. Với hệ thống có biến động lớn, tải trung bình cũng chưa đủ; cần xác định thêm tải giờ cao điểm, mức tăng đột biến và thời gian phải duy trì tải cao.
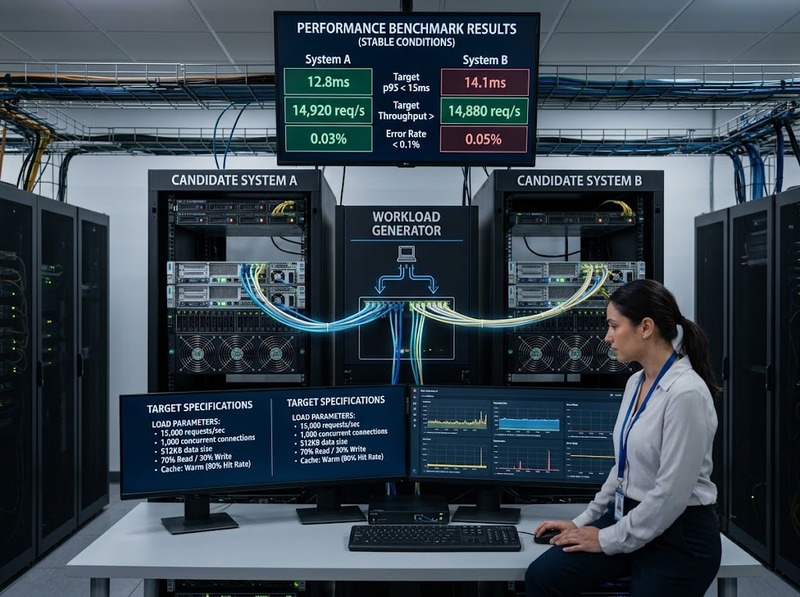
Chẳng hạn, thay vì đặt yêu cầu chung chung là “phản hồi nhanh”, có thể xây dựng một ngưỡng kiểm thử như: tại 500 request/giây, ít nhất 95% request phải hoàn thành trong 300 ms và tỷ lệ lỗi phải dưới 0,1%. Các con số này chỉ là ví dụ về cách định nghĩa tiêu chí; ngưỡng thực tế phải xuất phát từ nghiệp vụ và trải nghiệm mà hệ thống cần bảo đảm.
Điểm quan trọng là mọi phương án phải được đánh giá trên cùng điều kiện. So sánh hệ thống A ở 100 request/giây với hệ thống B ở 500 request/giây không cho biết hệ thống nào nhanh hơn. Cấu hình máy, kích thước dữ liệu, loại giao dịch, tỷ lệ đọc/ghi, số kết nối đồng thời, trạng thái cache và thời gian chạy cũng cần được kiểm soát nếu muốn kết quả có giá trị so sánh.
Đo tốc độ và độ trễ theo phân bố thay vì chỉ nhìn trung bình
Độ trễ cho biết một yêu cầu cần bao lâu để hoàn thành. Đây là chỉ số trực tiếp phản ánh khả năng đáp ứng, nhưng giá trị trung bình có thể che khuất các request chậm bất thường.
Giả sử phần lớn request hoàn thành rất nhanh nhưng một nhóm nhỏ mất vài giây. Thời gian trung bình vẫn có thể trông tốt, trong khi người dùng thuộc nhóm request chậm lại nhận trải nghiệm rất kém. Vì vậy, khi đánh giá hiệu năng hệ thống nên theo dõi phân vị độ trễ như p50, p95 và p99.
· p50 phản ánh thời gian phản hồi điển hình của khoảng một nửa số request
· p95 giúp quan sát nhóm request chậm hơn mà một tỷ lệ đáng kể người dùng có thể gặp
· p99 thể hiện phần đuôi của phân bố và thường làm lộ các vấn đề về hàng đợi, I/O, khóa tài nguyên hoặc phụ thuộc bên ngoài
Một hệ thống có p50 thấp nhưng p99 tăng mạnh khi tải cao chưa thể coi là ổn định. Khoảng cách ngày càng lớn giữa độ trễ điển hình và độ trễ đuôi cho thấy hiệu năng không phân bố đồng đều.
Cũng cần xác định chính xác điểm bắt đầu và kết thúc phép đo. Thời gian xử lý bên trong ứng dụng, thời gian phản hồi của API và thời gian người dùng nhận được kết quả có thể khác nhau do mạng, proxy, database hoặc các dịch vụ phụ thuộc. Hai benchmark sử dụng hai định nghĩa latency khác nhau không nên được so sánh trực tiếp.
Đánh giá thông lượng cùng với tải đồng thời
Thông lượng cho biết hệ thống hoàn thành được bao nhiêu đơn vị công việc trong một khoảng thời gian. Tùy loại hệ thống, đơn vị có thể là request/giây, transaction/giây, bản ghi/giây, job/phút hoặc một đại lượng nghiệp vụ tương đương.
Thông lượng không nên được đọc tách rời độ trễ. Khi tăng tải, một hệ thống có thể tiếp tục nhận thêm request nhưng không xử lý kịp. Hàng đợi dài ra, độ trễ tăng và cuối cùng xuất hiện timeout hoặc lỗi. Nếu chỉ nhìn số request gửi vào, khả năng xử lý thực tế có thể bị đánh giá cao hơn thực tế.
Cần phân biệt ba đại lượng:
Tải đưa vào là lượng công việc mà công cụ kiểm thử gửi tới hệ thống.
Thông lượng hoàn thành là lượng công việc hệ thống xử lý thành công.
Concurrency là số tác vụ hoặc người dùng đang hoạt động đồng thời.
Khi tải đưa vào tiếp tục tăng nhưng thông lượng hoàn thành gần như đứng yên, hệ thống đã tiến gần vùng bão hòa. Nếu độ trễ và lỗi đồng thời tăng nhanh, việc tiếp tục tăng concurrency thường chỉ làm hàng đợi lớn hơn chứ không tạo thêm năng lực xử lý.
Do đó, “chịu được 10.000 người dùng” là một mô tả thiếu thông tin nếu không biết 10.000 người dùng đó tạo bao nhiêu giao dịch, tần suất thao tác ra sao và hệ thống đáp ứng chúng với độ trễ nào. Workload phải phản ánh hành vi thực tế chứ không chỉ là số phiên kết nối.
Theo dõi tài nguyên để tìm điểm nghẽn và phần dung lượng dự phòng
Kết quả đầu ra cho biết hệ thống đang nhanh hay chậm; dữ liệu tài nguyên giúp giải thích tại sao. Trong một bài kiểm thử tải, cần quan sát CPU, bộ nhớ, I/O lưu trữ, lưu lượng mạng, connection pool, thread pool, hàng đợi và các tài nguyên giới hạn khác phù hợp với kiến trúc.
Mức sử dụng cao không tự động đồng nghĩa với hiệu năng kém. CPU chạy ở mức cao nhưng hệ thống vẫn giữ được độ trễ, thông lượng và tỷ lệ lỗi trong ngưỡng yêu cầu có thể là dấu hiệu tài nguyên đang được khai thác hiệu quả. Ngược lại, CPU thấp cũng không chứng minh hệ thống còn nhiều năng lực nếu bottleneck nằm ở database, khóa đồng thời, giới hạn kết nối, I/O hoặc dịch vụ bên ngoài.
Điều cần tìm là mối quan hệ giữa tải, tài nguyên và kết quả phục vụ. Ví dụ, nếu số request tăng 20% nhưng độ trễ p95 tăng gấp nhiều lần trong khi connection pool đã đầy, giới hạn chính không nằm ở khả năng tính toán của CPU. Tăng CPU khi đó có thể không giải quyết được vấn đề.
Phần dung lượng dự phòng cũng cần được xem xét trước khi lựa chọn. Một phương án chỉ vừa đủ đạt yêu cầu tại mức tải dự kiến sẽ có ít khoảng trống cho traffic tăng đột biến, dữ liệu lớn dần hoặc biến động trong vận hành. Phương án phù hợp hơn thường là phương án đáp ứng mục tiêu ở tải yêu cầu mà chưa tiến sát điểm bão hòa của tài nguyên quan trọng.
Kiểm tra hiệu năng khi tải tăng, tăng đột biến và kéo dài
Một lần benchmark ở trạng thái ổn định chỉ cho biết hệ thống hoạt động thế nào tại một điểm tải. Để hiểu khả năng đáp ứng thực tế, cần kiểm tra đường cong hiệu năng khi workload thay đổi.
Load test
Load test kiểm tra hệ thống ở mức tải dự kiến. Mục tiêu chính là xác nhận các yêu cầu về độ trễ, thông lượng và tỷ lệ lỗi có được duy trì trong điều kiện sử dụng đại diện hay không.
Stress test
Stress test tiếp tục tăng tải vượt mức vận hành dự kiến để tìm điểm giới hạn. Điểm cần quan sát không chỉ là lúc hệ thống ngừng hoạt động mà còn là thời điểm đầu tiên một mục tiêu quan trọng bị phá vỡ.
Nếu yêu cầu quy định p95 không vượt quá một ngưỡng nhất định, capacity hữu ích của hệ thống kết thúc khi p95 vượt ngưỡng đó, ngay cả khi máy chủ vẫn tiếp tục nhận request. Vì thế, capacity theo góc nhìn lựa chọn hệ thống nên được xác định bằng khả năng duy trì yêu cầu dịch vụ, không phải bằng thời điểm tài nguyên chạm 100%.
Spike test và soak test
Spike test tạo mức tăng tải nhanh để kiểm tra phản ứng trước lưu lượng đột biến. Đây là trường hợp quan trọng với hệ thống có autoscaling, bởi tài nguyên có thể mở rộng được nhưng tốc độ mở rộng không đủ nhanh để ngăn độ trễ hoặc lỗi tăng trong giai đoạn chuyển tiếp.
Soak test duy trì tải trong thời gian dài. Một hệ thống hoạt động tốt trong vài phút vẫn có thể suy giảm sau nhiều giờ vì rò rỉ bộ nhớ, backlog tích lũy, connection không được giải phóng, cache thay đổi hoặc công việc nền cạnh tranh tài nguyên.
Các loại kiểm thử này trả lời những câu hỏi khác nhau. Chỉ dùng một bài load test ngắn có thể bỏ qua giới hạn chỉ xuất hiện khi tải vượt đỉnh hoặc tồn tại lâu.
Đánh giá khả năng mở rộng qua đường cong tải và hiệu năng
Khả năng mở rộng không nên được đánh giá bằng việc hệ thống “có hỗ trợ scale” hay không. Điều cần đo là sau khi bổ sung tài nguyên, hệ thống xử lý được thêm bao nhiêu workload và có giữ được mục tiêu độ trễ hay không.
Một hệ thống mở rộng tốt sẽ tăng capacity tương đối ổn định khi tài nguyên được bổ sung, ít nhất trong phạm vi kiến trúc cho phép. Nếu tăng gấp đôi tài nguyên nhưng thông lượng chỉ tăng rất ít, có thể tồn tại một thành phần dùng chung đang trở thành nút thắt như database, storage, lock, network hoặc dịch vụ phụ thuộc.
Cần theo dõi đồng thời:
· Thông lượng đạt được trước và sau khi scale
· p95 hoặc p99 tại cùng mức tải
· Tỷ lệ lỗi và timeout
· Mức sử dụng tài nguyên của từng tầng
· Thời gian từ lúc tải tăng đến khi năng lực mới thực sự sẵn sàng
Hiệu năng cũng cần được xem xét theo chi phí tài nguyên. Hai phương án cùng đạt 1.000 transaction/giây với cùng ngưỡng latency chưa chắc tương đương nếu một phương án phải dùng lượng tài nguyên lớn hơn đáng kể. Trong trường hợp mục tiêu là lựa chọn một hệ thống phù hợp, hiệu quả tài nguyên cho biết capacity đạt được phải trả bằng bao nhiêu CPU, bộ nhớ hoặc số instance.
Tuy nhiên, không nên tối ưu chi phí bằng cách đưa hệ thống quá sát giới hạn vận hành. Hiệu suất tài nguyên và headroom có quan hệ đánh đổi: sử dụng tài nguyên càng sát trần thì chi phí có thể thấp hơn, nhưng dư địa hấp thụ tải bất thường cũng giảm.
So sánh các phương án bằng cùng một ma trận hiệu năng
Quyết định cuối cùng nên dựa trên một ma trận kết quả thay vì chọn hệ thống có một chỉ số nổi bật nhất. Mỗi phương án cần chạy cùng workload, cùng tập dữ liệu, cùng thời gian kiểm thử và cùng định nghĩa chỉ số.
Một ma trận tối thiểu có thể gồm:
|
Tiêu chí |
Cách đọc kết quả |
|
Độ trễ p50 |
Trải nghiệm điển hình |
|
Độ trễ p95/p99 |
Mức suy giảm ở nhóm request chậm |
|
Thông lượng |
Lượng công việc hoàn thành trong một đơn vị thời gian |
|
Tỷ lệ lỗi/timeout |
Khả năng duy trì tính hữu dụng khi tải tăng |
|
Tải tại điểm vi phạm SLO |
Capacity thực tế theo yêu cầu vận hành |
|
CPU, RAM, I/O, network |
Mức tài nguyên cần để tạo ra capacity |
|
Khả năng scale |
Mức capacity tăng thêm khi bổ sung tài nguyên |
|
Hiệu năng kéo dài |
Khả năng duy trì kết quả theo thời gian |
Trình tự lựa chọn cũng cần rõ ràng. Trước hết loại các phương án không đạt yêu cầu bắt buộc về latency, throughput hoặc lỗi tại workload mục tiêu. Trong số các hệ thống còn lại, so sánh headroom, mức sử dụng tài nguyên, độ ổn định của p95/p99 và khả năng mở rộng. Chỉ sau khi bảo đảm hiệu năng đạt yêu cầu mới có ý nghĩa khi tối ưu mức tài nguyên cần sử dụng.
Cách tiếp cận này tránh hai sai lầm phổ biến: chọn hệ thống có tốc độ tối đa cao nhưng suy giảm mạnh ở tải thực tế, hoặc chọn phương án có latency rất thấp ở tải nhẹ nhưng không duy trì được kết quả khi concurrency tăng.
Không có một ngưỡng tốc độ, độ trễ hay CPU duy nhất có thể dùng để kết luận mọi hệ thống đều “đủ nhanh”. Đánh giá hiệu năng hệ thống trước khi lựa chọn phải bắt đầu từ workload và mục tiêu đo được, sau đó kiểm tra đồng thời latency, throughput, lỗi và tài nguyên qua nhiều mức tải.
Phương án phù hợp là phương án duy trì được mục tiêu hiệu năng ở tải dự kiến, còn dung lượng dự phòng hợp lý, không xuất hiện điểm nghẽn nghiêm trọng và có đường cong mở rộng phù hợp khi nhu cầu tăng. Một benchmark chỉ có giá trị quyết định khi điều kiện kiểm thử giống với điều kiện mà hệ thống thực sự phải phục vụ.

GỬI Ý KIẾN BÌNH LUẬN
