
Cách đánh giá khả năng mở rộng hệ thống công nghệ
Mục lục
- Đánh giá khả năng mở rộng bắt đầu từ tải và năng lực xử lý
- Khả năng phục vụ thêm người dùng phải được đo bằng hành vi đồng thời
- Khả năng mở rộng theo dữ liệu phải được kiểm tra độc lập với traffic
- Phạm vi triển khai rộng hơn phải duy trì hiệu năng ở nhiều vùng và nhiều cụm
- Hiệu quả mở rộng cho biết thêm tài nguyên có thực sự tạo thêm năng lực
- Khả năng mở rộng chỉ đạt khi hiệu năng, lỗi và tài nguyên cùng nằm trong giới hạn
- Kết luận đánh giá nên dựa trên đường cong mở rộng thay vì một lần benchmark
Khả năng mở rộng của hệ thống công nghệ được đánh giá bằng cách tăng dần tải, người dùng, dữ liệu và phạm vi triển khai, đồng thời đo throughput, độ trễ, tỷ lệ lỗi, mức sử dụng tài nguyên và chi phí để xác định hệ thống còn duy trì mục tiêu dịch vụ hay không.
Khả năng mở rộng không nên được đánh giá bằng việc hệ thống “có thể thêm server” hay “đã dùng cloud”. Câu hỏi thực tế là: khi nhu cầu tăng, hệ thống có tăng năng lực xử lý tương ứng mà vẫn giữ được mức hiệu năng, độ ổn định và chi phí chấp nhận được hay không.
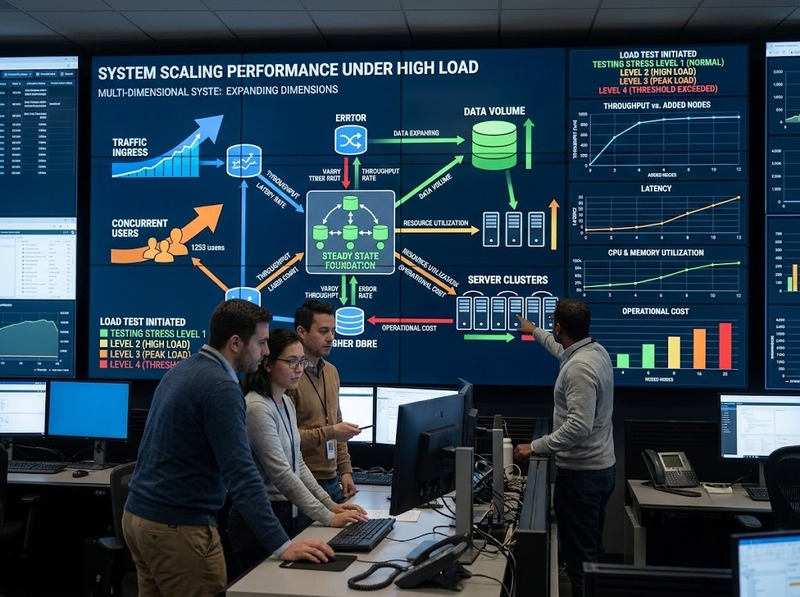
Việc đánh giá vì thế cần đặt hệ thống vào nhiều mức quy mô khác nhau, từ tải hiện tại đến tải mục tiêu và tải vượt dự kiến. Ở mỗi mức, cần đo đồng thời lượng công việc xử lý được, độ trễ, tỷ lệ lỗi, tài nguyên tiêu thụ và khả năng phục hồi sau khi tải giảm. Với hệ thống mở rộng tốt, tăng tài nguyên phải tạo ra mức tăng năng lực xử lý có ý nghĩa; nếu tài nguyên tăng mạnh nhưng throughput gần như đứng yên, một nút thắt đang giới hạn khả năng mở rộng.
Đánh giá khả năng mở rộng bắt đầu từ tải và năng lực xử lý
Tải là biến đầu tiên cần tăng có kiểm soát. Tùy loại hệ thống, tải có thể được biểu diễn bằng request mỗi giây, transaction mỗi giây, job đồng thời, message mỗi giây hoặc lượng dữ liệu xử lý trong một đơn vị thời gian.
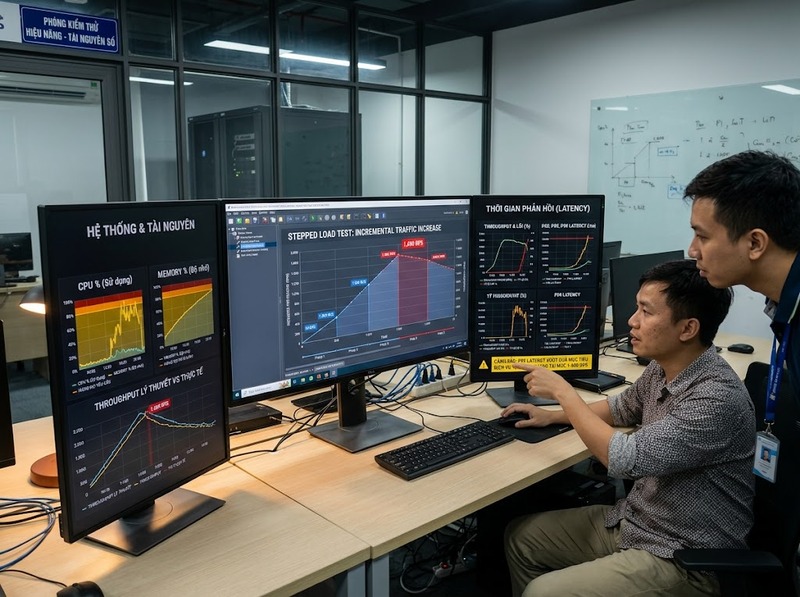
Một bài kiểm thử có thể tăng tải theo các nấc 100, 200, 400, 800 rồi 1.600 request/giây. Tại mỗi nấc, cần theo dõi ít nhất:
· Throughput thực tế
· Độ trễ theo percentile như p50, p95 hoặc p99
· Tỷ lệ request hoặc transaction lỗi
· CPU, bộ nhớ, I/O, network và connection pool
· Queue length hoặc backlog nếu hệ thống xử lý bất đồng bộ
Latency, error rate và throughput đều là những chỉ báo định lượng thường được sử dụng để xác định chất lượng dịch vụ. Google SRE cũng xem request latency, error rate và throughput là các Service Level Indicator phổ biến.
Điểm quan trọng không phải hệ thống đạt được con số request/giây lớn nhất, mà là mức tải cao nhất vẫn đáp ứng mục tiêu dịch vụ đã đặt ra. Ví dụ, nếu yêu cầu là p95 latency dưới 300 ms và error rate dưới 0,5%, thì mức tải mà một trong hai điều kiện này bắt đầu bị phá vỡ chính là tín hiệu cho thấy hệ thống đang tiến gần hoặc vượt giới hạn vận hành theo mục tiêu đó.
Stress test tiếp tục tăng tải vượt vùng mục tiêu để xác định breaking point và hành vi khi quá tải. Việc này giúp phân biệt hai hệ thống cùng phục vụ được 1.000 request/giây nhưng khác nhau đáng kể: một hệ thống suy giảm từ từ và phục hồi khi tải giảm, trong khi hệ thống kia xuất hiện timeout dây chuyền hoặc không tự phục hồi.
Microsoft khuyến nghị tăng traffic theo từng bước và theo dõi response time, throughput, error rate cùng resource utilization để tìm breaking point và bottleneck.
Khả năng phục vụ thêm người dùng phải được đo bằng hành vi đồng thời
Số tài khoản đăng ký không phản ánh trực tiếp khả năng mở rộng. Hai hệ thống cùng có một triệu tài khoản có thể tạo tải hoàn toàn khác nhau nếu một hệ thống chỉ có vài nghìn người dùng hoạt động đồng thời còn hệ thống kia có hàng trăm nghìn phiên đồng thời.
Do đó, đánh giá theo người dùng cần mô phỏng concurrency và hành vi thực tế, chẳng hạn:
· Số phiên hoạt động đồng thời
· Số request trung bình trên mỗi người dùng
· Tỷ lệ đọc và ghi
· Kích thước payload
· Thời gian giữ kết nối
· Tần suất đăng nhập, tìm kiếm, cập nhật hoặc tải dữ liệu
· Mức độ tập trung traffic vào giờ cao điểm
Giả sử 10.000 người dùng đồng thời tạo trung bình 0,2 request/giây mỗi người. Hệ thống phải tiếp nhận khoảng 2.000 request/giây trước khi tính thêm traffic nền, retry hoặc các tác vụ nội bộ. Nếu hành vi người dùng thay đổi thành 0,5 request/giây, cùng 10.000 người dùng đã tạo ra khoảng 5.000 request/giây. Vì vậy, chỉ báo “số người dùng tối đa” thiếu ý nghĩa nếu không gắn với workload model.
Cũng cần kiểm tra phân bố tải. Một hệ thống có thể phục vụ tổng số người dùng lớn nhưng gặp giới hạn khi nhiều người cùng truy cập một tenant, một shard, một tài nguyên dùng chung hoặc một endpoint. Đây là trường hợp tổng tài nguyên vẫn còn nhưng một thành phần cục bộ đã bão hòa.
Load test nên phản ánh gần nhất môi trường và hành vi sản xuất. AWS khuyến nghị kiểm thử scalability và performance trong môi trường có quy mô gần với production thay vì suy luận từ môi trường test thu nhỏ, đồng thời kiểm tra cả tài nguyên nền, cấu hình scaling, service quota và thiết kế resilience dưới tải.
Khả năng mở rộng theo dữ liệu phải được kiểm tra độc lập với traffic
Một hệ thống chạy tốt với 100 GB dữ liệu chưa chắc giữ được đặc tính đó khi dữ liệu tăng lên 1 TB hoặc 10 TB, ngay cả khi số request mỗi giây không thay đổi.
Khi dữ liệu tăng, hệ thống có thể phát sinh những giới hạn không xuất hiện trong load test với dataset nhỏ:
· Index lớn hơn làm tăng chi phí truy vấn và cập nhật
· Working set không còn nằm trong memory hoặc cache
· Scan, sort hoặc aggregation xử lý nhiều dữ liệu hơn
· Backup, restore và replication kéo dài
· Rebalancing hoặc resharding tạo thêm I/O và network traffic
· Batch job và data pipeline mất nhiều thời gian hơn để hoàn thành
· Storage hoặc database đạt quota hay giới hạn kỹ thuật trước compute layer
Vì vậy, một test matrix nên thay đổi traffic và data volume như hai biến độc lập. Ví dụ, cùng 1.000 request/giây nhưng chạy lần lượt với 100 GB, 1 TB và 5 TB dữ liệu. Nếu p95 latency tăng mạnh theo dataset dù CPU ứng dụng còn thấp, vấn đề mở rộng có thể nằm ở database, index, storage hoặc cách phân vùng dữ liệu chứ không phải application server.
Với hệ thống xử lý dữ liệu, throughput và end-to-end latency đặc biệt quan trọng: không chỉ cần biết hệ thống nhận được bao nhiêu dữ liệu mà còn phải biết dữ liệu mất bao lâu để đi từ ingestion đến khi xử lý hoàn tất. Google SRE sử dụng chính các loại chỉ báo này khi mô tả SLI cho data-processing system.
Một hệ thống chỉ được xem là mở rộng tốt theo dữ liệu khi tăng dataset không làm các tác vụ quan trọng vượt khỏi SLO hoặc cửa sổ xử lý đã định nghĩa, hoặc khi có thể bổ sung tài nguyên/phân vùng để khôi phục mục tiêu với chi phí hợp lý.
Phạm vi triển khai rộng hơn phải duy trì hiệu năng ở nhiều vùng và nhiều cụm
Khả năng mở rộng không dừng ở việc tăng số instance trong một cluster. Khi sản phẩm phát triển, hệ thống có thể phải phục vụ thêm tenant, cluster, availability zone, region hoặc nhóm người dùng phân bố ở nhiều khu vực địa lý.
Lúc này cần kiểm tra những yếu tố mà một bài load test trong một datacenter khó phát hiện:
· Network latency giữa các thành phần
· Băng thông liên vùng
· Replication lag
· Phân phối traffic giữa region
· Khả năng mất một node, zone hoặc cluster
· Service quota theo region
· Độ lệch hiệu năng giữa các khu vực
· Thời gian scale khi một khu vực nhận traffic tăng đột biến
Microsoft lưu ý rằng kiểm thử trong điều kiện thực tế có thể bộc lộ ảnh hưởng của phân bố địa lý, network latency, bandwidth, dependency bên ngoài và hành vi cache mà môi trường mô phỏng đơn giản có thể không thể hiện đầy đủ.
Đánh giá theo phạm vi triển khai vì thế phải trả lời hai câu hỏi khác nhau. Thứ nhất, khi thêm region hoặc cluster, tổng capacity có tăng như dự kiến hay không. Thứ hai, khi mất một phần capacity, phần còn lại có tiếp nhận tải chuyển sang mà vẫn giữ chất lượng dịch vụ trong giới hạn cho phép hay không.
Capacity planning cũng phải xét ràng buộc vị trí. Tài nguyên dư thừa ở một khu vực không nhất thiết giải quyết thiếu capacity ở khu vực khác nếu yêu cầu latency buộc dịch vụ phải nằm gần người dùng.
Hiệu quả mở rộng cho biết thêm tài nguyên có thực sự tạo thêm năng lực
Một trong những cách trực tiếp nhất để đánh giá scalability là so sánh mức tăng tài nguyên với mức tăng throughput.
Có thể biểu diễn đơn giản:
Hiệu quả mở rộng = % tăng throughput / % tăng tài nguyên
Nếu tài nguyên tăng 100% và throughput cũng tăng xấp xỉ 100%, hiệu quả mở rộng gần 1. Nếu tài nguyên tăng 100% nhưng throughput chỉ tăng 30%, hệ thống đang có mức sinh lợi năng lực thấp từ tài nguyên bổ sung.
Microsoft Azure Architecture Center mô tả scalability theo tỷ lệ giữa throughput gain và resource increase; trong trường hợp lý tưởng, tăng gấp đôi tài nguyên sẽ tạo throughput gần gấp đôi. Các bottleneck hoặc điểm đồng bộ thường khiến quan hệ này lệch khỏi tỷ lệ tuyến tính.
Ví dụ:
|
Tài nguyên |
Throughput |
Hiệu quả so với mức trước |
|
4 instance |
2.000 req/s |
Mốc cơ sở |
|
8 instance |
3.800 req/s |
95% so với tăng tuyến tính |
|
16 instance |
5.000 req/s |
Khoảng 32% cho lần tăng tài nguyên tiếp theo |
Từ 4 lên 8 instance, hệ thống gần đạt scaling tuyến tính. Nhưng từ 8 lên 16 instance, throughput chỉ tăng từ 3.800 lên 5.000 request/giây. Việc thêm compute lúc này không còn giải quyết đúng bottleneck.
Nguyên nhân có thể nằm ở database, lock, tài nguyên dùng chung, queue, network, storage hoặc một dependency không mở rộng cùng application tier. Vì vậy, CPU thấp trên một nhóm server không chứng minh toàn hệ thống còn capacity.
Chi phí cũng cần được đặt cạnh throughput. Một cấu hình tạo thêm 20% capacity nhưng làm chi phí tăng 100% vẫn có thể đáp ứng tải về mặt kỹ thuật, song có hiệu quả mở rộng thấp về mặt vận hành.
Khả năng mở rộng chỉ đạt khi hiệu năng, lỗi và tài nguyên cùng nằm trong giới hạn
Không nên dùng một KPI đơn lẻ để kết luận hệ thống có khả năng mở rộng. Throughput tăng có thể đi cùng latency tăng mạnh; latency vẫn thấp có thể do hệ thống từ chối một phần request; CPU ổn định có thể che giấu database hoặc queue đã bão hòa.
Một bộ tiêu chí đánh giá thực tế có thể được tổ chức như sau:
|
Nhóm |
Chỉ số cần theo dõi |
Câu hỏi đánh giá |
|
Năng lực |
Throughput, transaction rate |
Capacity có tăng cùng nhu cầu không? |
|
Trải nghiệm |
p95/p99 latency |
Độ trễ còn nằm trong SLO không? |
|
Độ ổn định |
Error rate, timeout |
Tỷ lệ lỗi có tăng khi scale không? |
|
Tài nguyên |
CPU, RAM, I/O, network |
Thành phần nào tiến tới bão hòa? |
|
Hàng đợi |
Queue depth, processing lag |
Hệ thống có đang tích lũy công việc chưa xử lý? |
|
Dữ liệu |
Query latency, replication lag, batch duration |
Dataset lớn có làm giảm năng lực không? |
|
Scaling |
Scale-out time, scale-in time |
Capacity mới có được bổ sung đủ nhanh không? |
|
Hiệu quả |
Throughput trên mỗi đơn vị tài nguyên hoặc chi phí |
Thêm tài nguyên còn tạo capacity tương xứng không? |
Không tồn tại một ngưỡng p95, CPU hay error rate duy nhất phù hợp cho mọi hệ thống. Ngưỡng phải được xác định từ SLO và đặc tính workload. Một API tương tác trực tiếp với người dùng, hệ thống thanh toán và batch pipeline có thể có yêu cầu latency hoàn toàn khác nhau.
Capacity cũng không nên được suy ra từ cấu hình lý thuyết. Google SRE khuyến nghị dùng load testing để xác lập quan hệ giữa lượng tài nguyên và năng lực dịch vụ, đồng thời kiểm tra lại quan hệ đó khi phần mềm thay đổi.
Kết luận đánh giá nên dựa trên đường cong mở rộng thay vì một lần benchmark
Một benchmark ở một mức tải chỉ cho biết hiệu năng tại điểm đó. Khả năng mở rộng được thể hiện rõ hơn bằng đường cong thay đổi của hệ thống khi quy mô tăng.
Quy trình đánh giá có thể dùng các mức:
1. Xác định workload hiện tại và workload mục tiêu
2. Xác định SLO hoặc ngưỡng chấp nhận cho latency, lỗi và throughput
3. Chạy baseline với tài nguyên và dataset hiện tại
4. Tăng dần traffic hoặc concurrency
5. Lặp lại với dataset lớn hơn
6. Tăng tài nguyên theo từng nấc và đo throughput gain
7. Kiểm tra ở nhiều cluster hoặc region nếu đó là phạm vi triển khai mục tiêu
8. Đẩy hệ thống qua mức thiết kế để xác định breaking point và khả năng phục hồi
Kết quả tốt không nhất thiết là một đường thẳng hoàn hảo. Hầu hết hệ thống đều có điểm mà scaling efficiency giảm dần. Mục tiêu của phép đánh giá là xác định điểm đó nằm ở đâu, thành phần nào gây ra nó và liệu điểm giới hạn có cao hơn nhu cầu dự kiến với biên capacity phù hợp hay không.
Google SRE xem demand forecasting, capacity planning và load testing định kỳ là những thành phần trực tiếp của việc đảm bảo đủ capacity cho nhu cầu tương lai; capacity phải được liên hệ với năng lực dịch vụ thực tế thay vì chỉ đếm server, disk hoặc tài nguyên thô.
Khả năng mở rộng hệ thống công nghệ được đánh giá tốt nhất bằng một chuỗi thử nghiệm có kiểm soát thay vì một con số duy nhất. Hệ thống cần được tăng tải, số người dùng đồng thời, dữ liệu và phạm vi triển khai; tại mỗi bước phải đo throughput, percentile latency, tỷ lệ lỗi, mức bão hòa tài nguyên và chi phí.
Một hệ thống có khả năng mở rộng tốt khi nhu cầu tăng vẫn có thể được đáp ứng bằng capacity bổ sung mà các SLO quan trọng không bị phá vỡ, lỗi không tăng ngoài giới hạn, bottleneck không xuất hiện quá sớm và throughput tăng đủ tương xứng với tài nguyên đã thêm. Ngược lại, nếu thêm nhiều tài nguyên nhưng năng lực gần như không tăng, latency hoặc lỗi tăng nhanh, hay một dependency đạt trần trước các thành phần còn lại, giới hạn mở rộng đã xuất hiện và cần được xác định ở đúng tầng gây nghẽn.

GỬI Ý KIẾN BÌNH LUẬN
